

一個文件實驗曾停在「請求的模型不可用」。原始報告用來支持這個分類的理由,是沒有拿到精確的 runtime 模型識別碼與實際推理強度。這個理由本身,無法證明執行器拒絕啟動。
這兩件事被混在一起,任務就停在錯的分類上。
2026-09-28 留下的後續紀錄,把「設定是否被接受並開始執行」和「執行環境是否揭露全部中繼資料」分開。原本的部分完成報告保留,修正說明與重跑產物另存,任務才有一個可重新進入的位置。
這不是隔夜耐久測試,也不能證明 Agent 可以連續工作多久。它示範的是較小、但必要的能力:
長任務必須能從可查核的狀態繼續;中斷後先辨認缺口,再決定重跑哪一步。
Day 23 談多個 Repository 如何共用能力。這一篇處理時間尺度上的延續(Temporal Scale):同一個任務停下或換一輪執行後,哪些狀態還能使用?
這次文件實驗的 Git 歷史有三個可定位階段:
| 紀錄 | 留下的狀態 |
|---|---|
11c2a55 建立 Round 1.2 |
固定這輪要使用的輸入與規則 |
770f199 保存 PARTIAL |
原始停止報告與驗證材料保留,尚無可接受的重跑成果 |
cb026f8 保存 RERUN COMPLETE |
增加分類修正、兩份重跑產物與評估,沒有覆蓋原始報告 |
提交時間只表示紀錄何時進入 Git,不能拿來當模型執行時間。
重新開始時也沒有換掉題目。PARTIAL 與 RERUN COMPLETE 使用的同一份測試輸入,Git 內容雜湊相同。這讓後續評估能分辨:改的是可用性判斷與執行結果,並非偷偷換了一份比較容易通過的輸入。
可恢復的檢查點(Checkpoint),至少要讓接手者知道下列事實:
固定輸入:同一份規則與階段對照
已完成:輸入檢查、原始嘗試與停止原因已留存
缺口:把缺少runtime資訊誤判成不能執行
下一步:依修正分類重跑限定材料化任務
仍禁止:改正式文章或把未驗證資訊補成已知
「完成 60%」沒有說清楚這些事。下一輪可能從頭重新整理輸入,也可能把原先的停止標籤當成不可推翻的事實。
保留原始失敗紀錄,則能看到哪一個假設被修正:缺少模型識別碼,只證明該資訊未揭露,不能單獨證明執行器沒有接受任務。
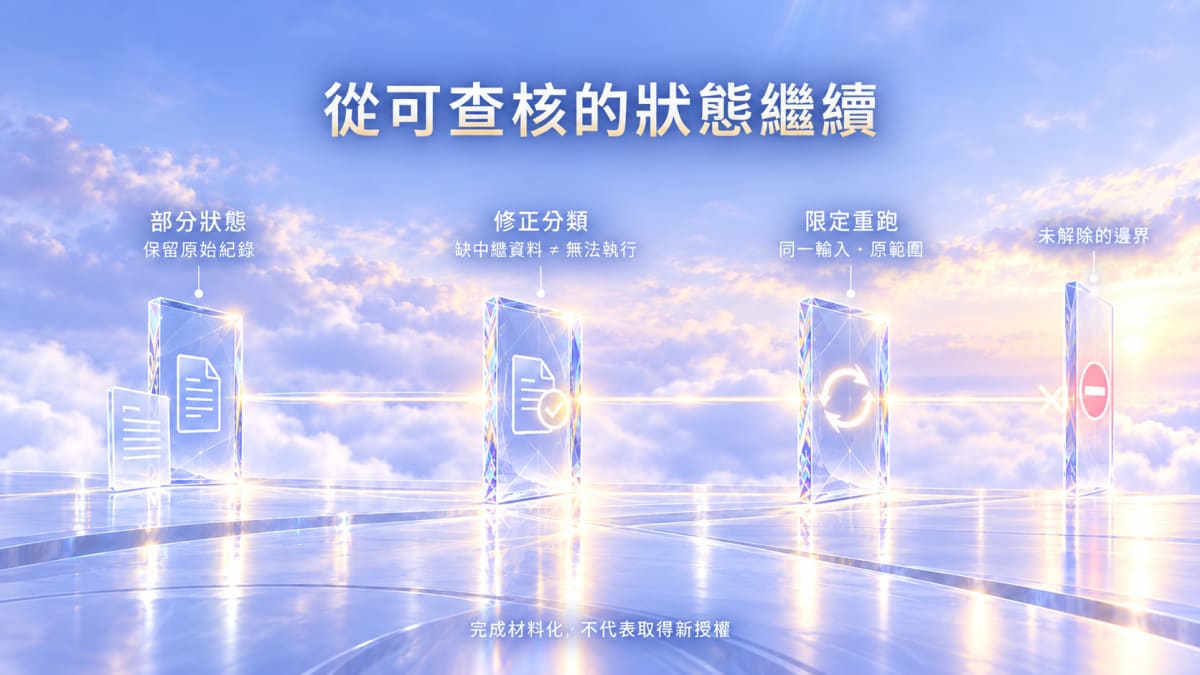
修正後的紀錄把可用性分成兩種:
精確模型識別碼與實際推理強度仍可維持未知。重跑報告自述請求已被接受、執行已開始;本輪能讀到這份回報,沒有取得獨立 runtime telemetry,因此不把它再升級成精確模型身份已驗證。
重試的依據也要依操作區分。重新讀取檔案或在隔離輸入上重做測試,與再次提交遠端寫入,風險不同。若外部操作的結果不明,先查實際狀態,再決定是否重試;不能因為上一輪沒收到成功訊息,就假設沒有副作用。
保存的重跑提交新增實驗文件,保留原始報告,沒有正式文章的 diff;這是 Git 內容可查核的範圍。
重跑後,評估文件逐項比較固定輸入與兩份產物:當階段必要規則、短版保護條款,以及延後階段的識別項目,是否依約保留。
這是對產物的靜態檢查,不是模型安全性或長時間穩定性的測試。工作報告裡的讀寫範圍與執行設定,也仍是回報資訊,沒有完整工具軌跡可獨立還原。
任務因此可以在限定範圍完成,同時保留其他未知:
材料化產物與對照評估:已交付
精確runtime身份/實際推理強度:未取得
正式文章需要的主要證據:仍待重查
正式文章修改/發布:不在本輪範圍
如果把 RERUN COMPLETE 縮成「全部完成」,下一個 Session 仍可能跨過原本的停止界線。
OpenAI 的 GPT‑6 系列指南將長時間任務拆成三種可操作機制:steering、async tools 與 delegation。
回到這次 PARTIAL → RERUN COMPLETE 案例,可以得到比「延長 timeout」更完整的控制方式:
Checkpoint:現在已知什麼、做到哪裡
Steer:新證據出現後,哪條路徑需要調整
Continue:哪些獨立工作還能安全繼續
Wait:哪些步驟確實依賴尚未返回的結果或人的決定
Retry:失敗後重跑哪一個有明確範圍的步驟
Stop:哪些限制尚未解除,不得自行跨越
這也說明為什麼「能連續執行數小時或數天」不是本文要證明的重點。執行時間只代表可持續運作的時長;真正決定任務能否可靠延續的,是能否重建狀態、辨識依賴關係,以及在執行途中透過 steering 因應變化,而不假裝已完成的動作可以撤銷。
本系列沒有對 GPT‑6 進行隔夜耐久測試,也沒有在這個案例實際使用 async tool 或 multi-agent delegation。官方機制僅補充控制平面的概念與詞彙;主要證據仍來自這次的 Git checkpoint、錯誤分類與有明確範圍的重新執行。
這次案例同時保留了兩種停止條件:
一種是可修正的分類問題。新的執行回報讓「不可用」不再成立,任務可以沿原範圍重試。
另一種是未解除的內容與授權邊界。文件材料化完成,沒有替正式文章補出缺少的證據,也沒有授權發布。
長任務需要的是這種區分:哪些失敗可以在既有範圍重試,哪些條件必須補證或取得新授權。把 timeout 拉長,無法替任務回答。
Git、工作單、計畫與交接紀錄都能保存檢查點,不必先建立新平台。先讓固定輸入、已知結果、未解缺口與下一個安全動作可以重新取得,再評估是否需要更複雜的協調工具。
下一篇會檢查另一種累積:為了讓 Agent 繼續工作而增加的規則,哪些已經重複,應該合併或刪短?


 iThome鐵人賽
 看影片追技術